把驗血報告貼給 AI 看,它會在哪裡出錯?AI 解讀檢驗報告:從六項研究歸納的三類出錯
把驗血報告貼給 AI 解讀會怎麼出錯?本文把六項同儕審查研究裡看到的出錯情形歸成三類:溝通斷在半路、資料有誤時順著講、說得通順但內容不對,並整理各研究測了什麼模型、在什麼條件下表現好或差;直接測檢驗數值或報告的只有兩項。AI 是參考方向,不是醫療診斷。
作者 蔡嘉櫸博士|臺灣大學醫學院生化暨分子生物學研究所博士、臺灣大學兼任助理教授、好命生醫 Homnia 創辦人暨執行長。研究訓練背景為 Dana-Farber Cancer Institute(Harvard Medical School)。曾主導第二型糖尿病新藥推進至美國 FDA 一期臨床,並建立 ISO/IEC 17025 認證檢驗實驗室。
重點
本文把六項研究裡看到的出錯情形歸成三類:你和 AI 之間的溝通斷在半路、資料不完整或有誤時它照單全收、說得頭頭是道但內容是錯的(幻覺)。只有第三類有檢驗報告情境的直接證據,前兩類來自一般醫療情境與模擬案例。
AI 提供的是健康管理的參考方向,不是醫療診斷;診斷與治療必須由醫師負責。
結果跟著模型版本、提問方式、檢驗項目與誰在用而變。例如一項納入 1,298 位英國成人的隨機試驗中,AI 單獨作答時在 94.9% 的測試提出至少一個相關病況,交給真人使用時不到 34.5%(Bean et al., 2026)。
把驗血報告貼給 AI,幾秒後它就列出一長串白話說明。先給答案:AI 解讀檢驗報告會怎麼出錯,本文把六項研究裡看到的出錯情形歸成三類,分別是你和它之間的溝通斷在半路、報告資訊不完整或有誤時它照單全收、以及說得頭頭是道卻是錯的(幻覺,hallucination)。其中只有第三類有檢驗報告情境的直接證據(尿液報告的研究);第一類來自一般醫療情境的試驗,第二類來自模擬案例的測試。AI 提供的是健康管理的參考方向,不是醫療診斷;診斷與治療必須由醫師負責。六項研究中,直接拿檢驗數值或檢驗報告來測的只有兩項;每一項結果都只代表當時受測的模型版本與測試條件。本文只談 AI 會怎麼錯、在什麼條件下表現比較好,不比較 AI 和醫師誰比較強。
把驗血報告貼給 AI,它到底在做什麼?
你把報告貼進對話框,AI 做的事,是根據它讀過的大量文字,接出「最像合理說明」的下一句話。這類模型叫大型語言模型(LLM,用海量文字訓練、擅長寫出通順語句的 AI)。它很會把術語翻成白話,但「通順」和「正確」是兩件事。
麻煩在於,錯的說明和對的說明,讀起來一樣有自信。研究者把這種現象叫幻覺:模型說得頭頭是道,內容卻是錯的。
先講清楚範圍。下面引用的研究,多半用模擬案例、測試題或刻意設陷阱的測試,不是真實民眾上傳自己的報告。
這六項研究各測了什麼?
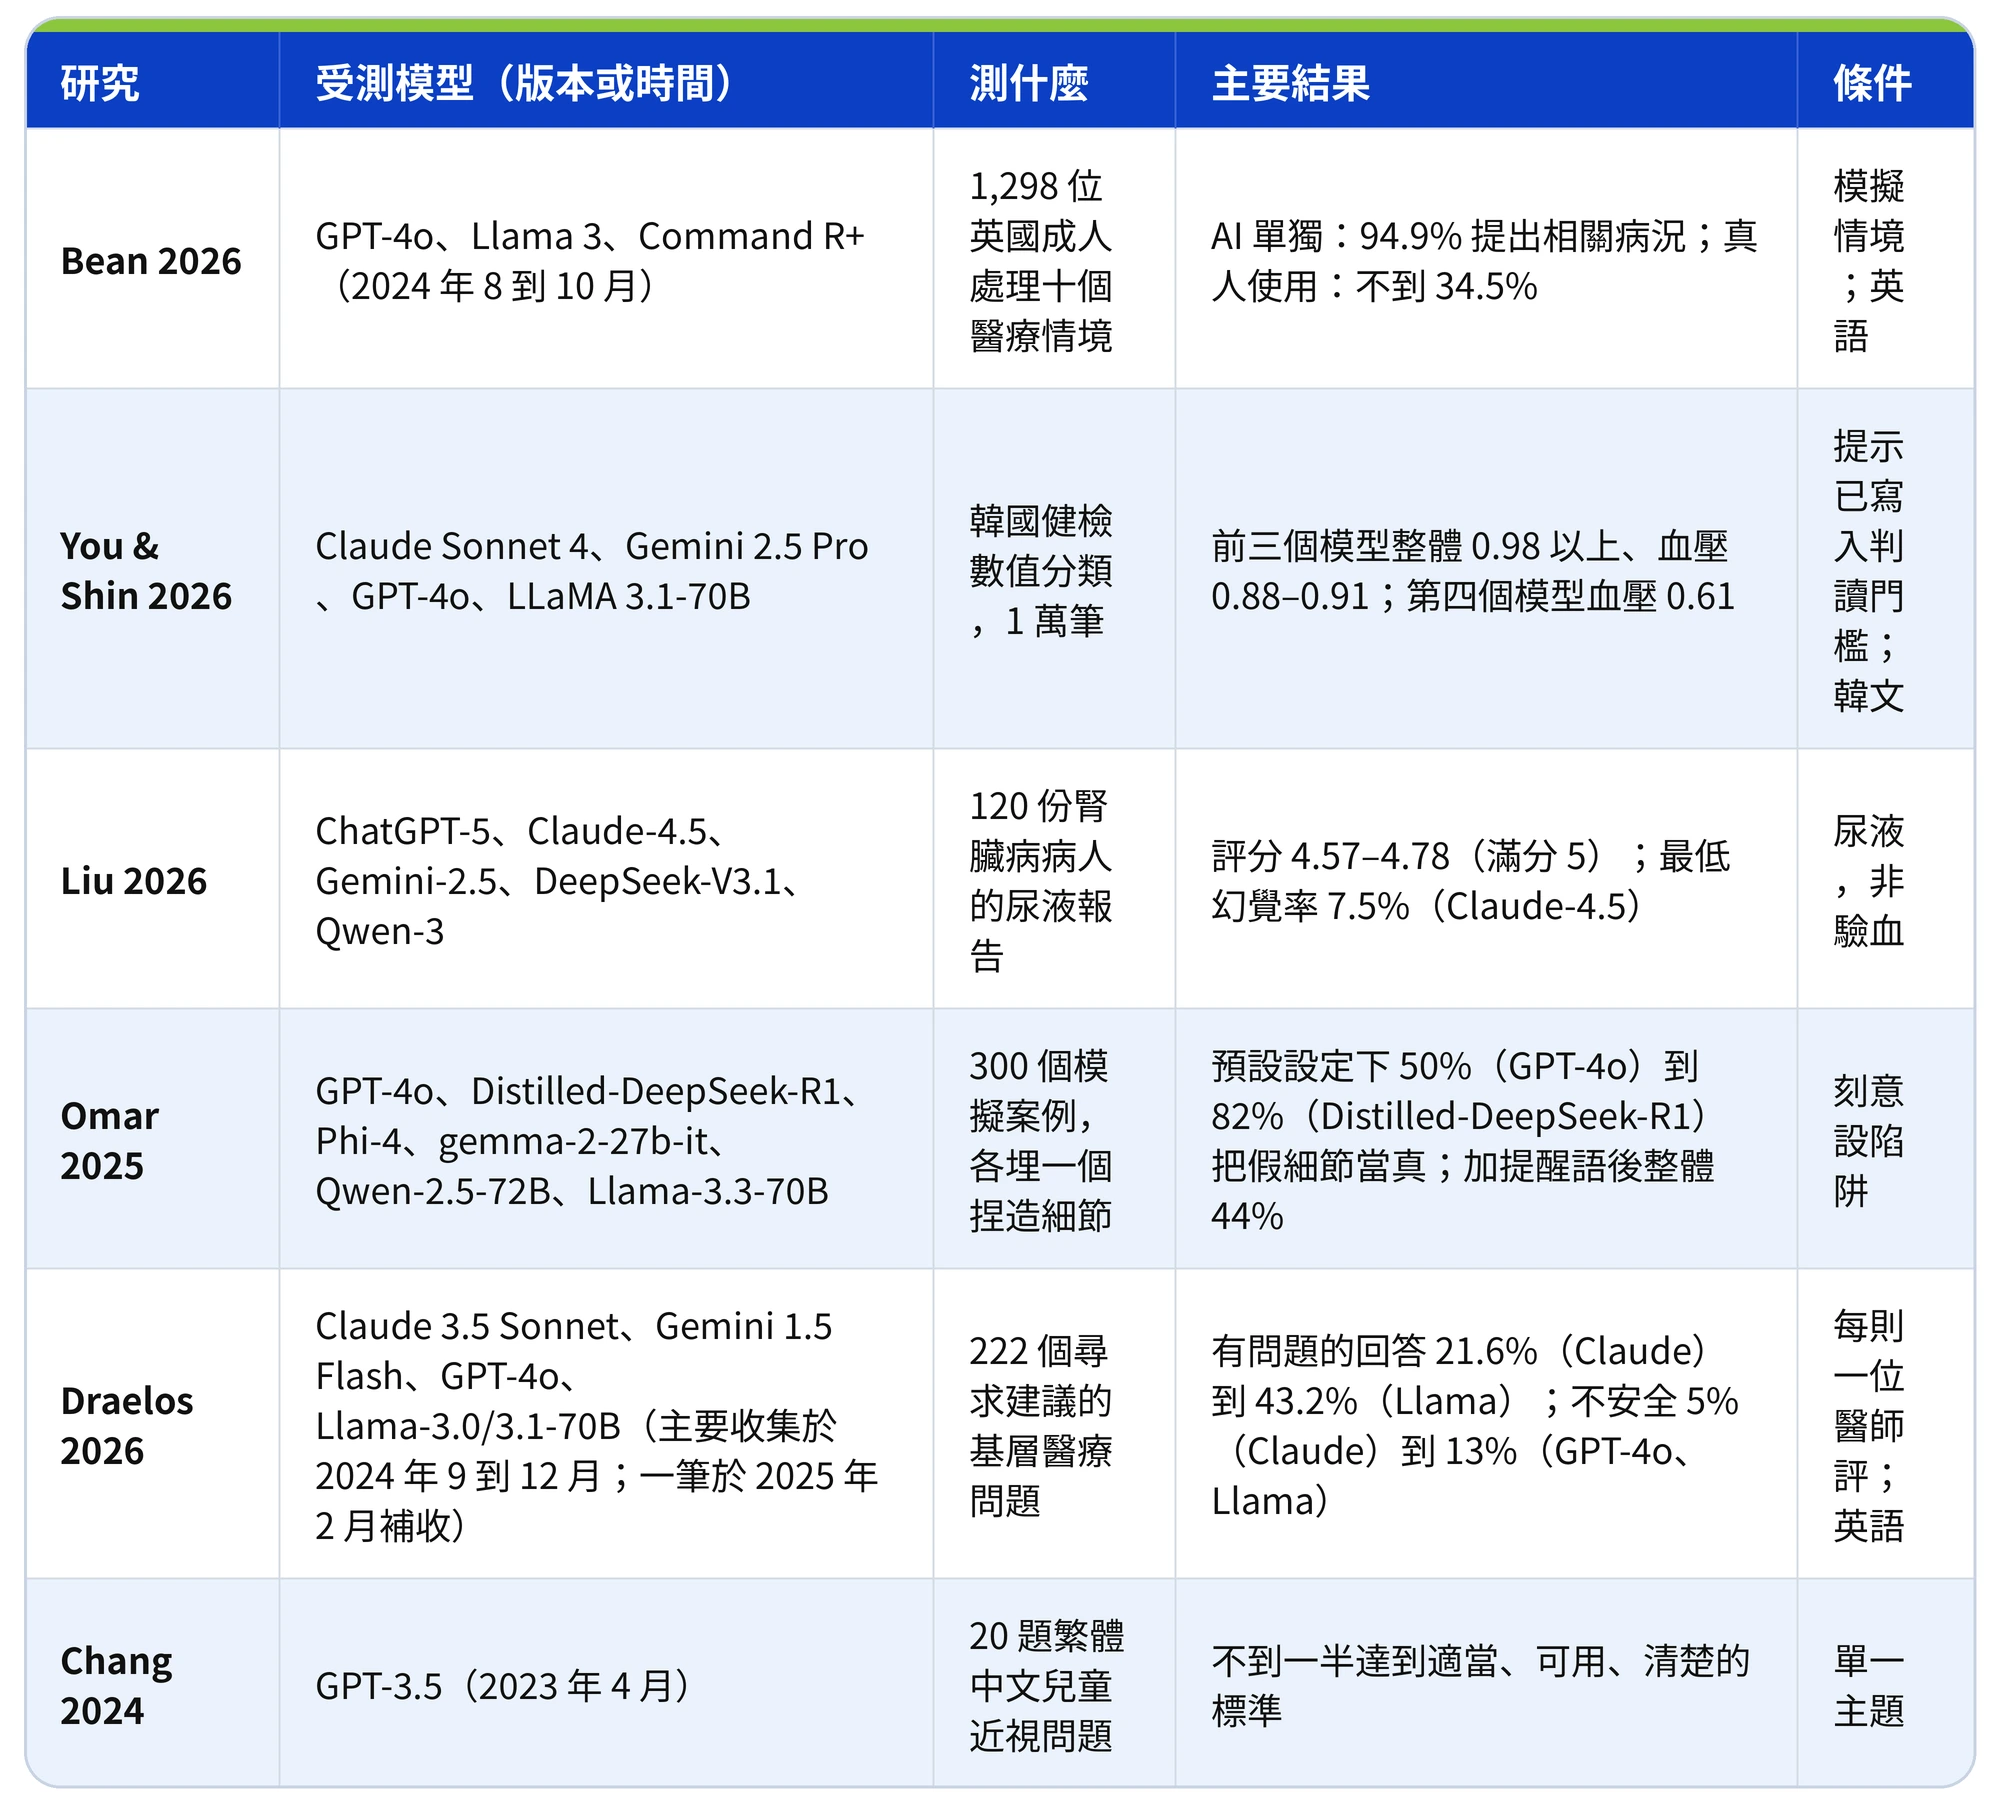
三類出錯情形是本文的歸納,不是任何一項研究的分類;每一類的證據來自哪種情境,看下表「測什麼」一欄。
AI 單獨測試很會答,為什麼真人用起來差很多?
一項發表在 Nature Medicine 的隨機試驗找了 1,298 位英國成人,請他們處理十個醫療情境:判斷可能是什麼狀況,以及選擇下一步的處置方向。三組受試者各使用一個 AI,對照組則用自己慣用的資源。
AI 單獨作答時,在 94.9% 的測試中提出至少一個相關病況,選對處置方向的比例是 56.3%。但真人拿同樣的 AI 來用,辨識出相關病況的比例不到 34.5%,處置方向不到 44.2%。和對照組相比,使用 AI 的人辨識病況顯著較差(對照組辨識出相關病況的勝算是 1.76 倍),處置方向則沒有顯著差異(Bean et al., 2026)。
研究者檢視對話紀錄:抽查的 30 段對話中,有 16 段使用者一開始只提供了部分資訊;也有 AI 誤解使用者提問的情形;AI 提出了相關病況,使用者也不一定採納。作者的結論是:使用者與 AI 的互動是部署上的挑戰,而常見的醫學知識題庫成績,預測不了這種落差。
這不是 AI 與醫師的比較,這項研究裡沒有醫師參賽。它說的是,知識放在模型裡,不等於知識能順利走到使用者手上。
報告上的數字,AI 讀得對嗎?
要看怎麼問、問哪一項。韓國團隊用韓國國民健康保險公團的健檢資料測試四個 LLM,看模型能不能把每個項目歸到正確的類別,分數代表與標準答案相符的比例(You & Shin, 2026)。
提問方式的影響很大。在 100 筆的抽樣測試中,只下一句「請解讀這些數值」時,四個模型平均是 0.69;把角色、範例、各項目的判讀門檻都寫進提示,並要求逐步比對之後,升到 0.95,其中進步最大的一步來自把判讀門檻寫進提示(0.80 升到 0.92)。如果只丟一句「幫我看看」,情境比較接近前者。
用表現最好的那種提示去跑 1 萬筆個案,前三個模型在血糖、膽固醇、三酸甘油酯、肝臟酵素等多數生化項目的分數接近滿分(0.99–1.00),血壓是 0.88 到 0.91;第四個模型(LLaMA 3.1-70B)在同一批生化項目是 0.66 到 0.98,血壓 0.61。血壓判讀隨受檢者年紀下降的情形,出現在其中兩個模型。作者推測,原因是血壓要同時整合收縮壓與舒張壓,分類門檻又有好幾層。這項研究只做數值分類,沒有評估幻覺。
另一項研究用的是真實的檢驗報告:120 份腎臟病病人的尿液報告,交給五個 LLM 解讀,由 4 位醫檢師與 4 位醫師評分(Liu et al., 2026)。五個模型的整體評分都在 4.57 到 4.78 分之間(滿分 5 分),辨認異常項目與分析項目間的關聯做得好,解讀儀器加註的旗標則較差。幻覺率最低的模型是 7.5%(計算方式摘要未說明),常見的幻覺型態是誤解、定義錯誤與過度詮釋。
報告裡只要有一個錯的細節,AI 會自己發現嗎?
在這項測試裡,多數時候不會。Omar 等人做了一個對抗式測試,也就是刻意設陷阱的壓力測試:300 個經醫師審核的模擬臨床案例,每一個都放進一個捏造的細節,例如不存在的檢驗項目、不存在的徵象,或虛構的症候群,再交給六個 LLM。在預設設定下,模型把捏造細節當真、順著解釋的比例,依模型與案例長短不同落在 50% 到 82% 之間,整體是 66%。加上降低幻覺的提醒語後,整體降到 44%,表現最好的模型從 53% 降到 23%;提醒有用,但消除不了(Omar et al., 2025)。
這是刻意設計的極端情境,不等於日常使用的出錯率。但它指出一個機制:模型傾向把你給它的內容當成事實來接續。
用一個假設情境來想像(這是為了說明而設,不是該研究直接測試的項目):報告轉成文字時,某個單位或數字被辨識錯了,AI 可能拿著那個錯的數字,繼續寫出一段很順的解釋。
一般人問健康問題,AI 的回答有多少問題?
Draelos 等人請醫師審查四個公開聊天機器人,對 222 個民眾常問的基層醫療問題所做的 888 則回答;題目限於「該怎麼處理」這類尋求建議的問題(Draelos et al., 2026)。有問題的回答占 21.6% 到 43.2%,被評為不安全的占 5% 到 13%,機器人之間有統計上的顯著差異。重點不在排名,也不在和醫師比較,而是每一種都有一定比例的問題回答。
繁體中文的研究,本文只納入一項。Chang 等人檢視 ChatGPT 用繁體中文回答 20 題兒童近視常見問題,由 10 位眼科醫師評分:不到一半的回答達到適當、可用、清楚的標準,其中治療效果與副作用相關的題目特別不足(Chang et al., 2024)。受測的是 2023 年 4 月的 GPT-3.5。這是單一主題,與驗血報告無關。它只能說明,繁體中文的情境沒有理由被當成「已經驗證過」。
民眾會不會太相信 AI?上傳報告的隱私呢?
上面六項研究的主題都不是過度信賴或隱私;其中英國試驗看到的,反而是使用者不一定採納 AI 的建議。另外查到的研究,情境不是檢驗報告:兩個隨機實驗(338 名大學生、563 名線上受試者)請受試者評 AI 改寫的出院衛教指示,越習慣依賴生成式 AI 的人,越信任它的輸出,信任度也越不隨內容正誤而變(Ahmed et al., 2026);一篇範疇回顧整理 27 項研究,其中 4 項把隱私或資料安全的顧慮列為使用障礙(Alon & Levkovich, 2026)。
針對「檢驗報告」情境的過度信賴研究,以及量化「上傳報告」實際隱私風險的研究,我們沒有查到。沒找到,不代表沒有問題,也不能寫成已有證據,只能如實標示為缺口。資料如何保存與使用,取決於各服務的資料政策。
這些研究能回答什麼、不能回答什麼?
這幾項研究加在一起,能讓我們看見出錯的型態,以及表現比較好的條件(結構化的數值、提示裡寫明判讀門檻),但不能回答「AI 解讀我的報告到底可不可靠」。
第一,幾乎都不是真實使用。 各研究的測試條件見上表;唯一用真實報告的尿液研究,也不是民眾自己上傳提問。
第二,台灣適用性未知。 英國試驗的受試者是英國成人,以英語進行;韓國研究以韓文提示,健檢項目與參考範圍和台灣不一定相同。本文納入的繁體中文研究,只有近視單一主題。
第三,各研究的衡量方式不同,不能換算成一個「AI 準確度」。 本文不提供這種總結數字。
第四,模型更新很快。 這些結果是某個時間點的快照,只對應上表列出的版本。
把報告貼給 AI 之後,可以怎麼用它的回答?
把 AI 的回答當成整理與提問的起點,而不是結論。
在讀它的回答時,可以問自己三件事:這句話對應到報告上的哪一行?我給它的資料完整、正確嗎?它說的是「描述」,還是「下了結論」?
報告背後的病史、用藥與當天的狀況,AI 都看不到,這些是判讀的關鍵,要由負責診治的專業人員整合。AI 整理出來的內容,是和他們討論時的素材,不是替代。
就醫時機、追蹤頻率,以及飲食、運動與用藥,要依個人狀況由醫師評估,不是一篇文章能替你判斷的。延伸閱讀:智慧手錶偵測心律不整準嗎?它能偵測什麼、不能排除什麼
利益揭露 :作者為代謝體檢測服務公司好命生醫 Homnia 創辦人暨執行長,該公司有 AI 健康分析相關服務。本文引用之國際同儕審查文獻皆為獨立第三方研究,與 Homnia 無關;本文未引用 Homnia 自有資料,不評論任何特定產品,正文亦未提及 Homnia 任何產品、服務或方法論。
常見問題
AI 幫我解讀驗血報告,可以當成診斷嗎?
不行。AI 可以把報告上的項目整理成白話,但它不知道你的病史、用藥和當天的狀況,而這些正是判讀的關鍵。判讀與治療要由負責診治的醫師來做,AI 的整理只能當作提問的起點。
為什麼 AI 單獨測試成績很高,一般人用起來卻差很多?
一項納入 1,298 位英國成人的隨機試驗發現,同樣的 AI 單獨作答時,在 94.9% 的測試中提出至少一個相關病況,真人使用時不到 34.5%(Bean et al., 2026)。研究者檢視對話後認為,問題出在人與 AI 的互動:使用者常常只給部分資訊,AI 有時誤解提問,它提出的建議也不一定被採納。
報告裡有寫錯的資訊,AI 會幫我抓出來嗎?
不一定。一項測試在 300 個模擬案例中各埋入一個捏造細節,在預設設定下,六個 LLM 把假細節當真的比例落在 50% 到 82%;加上提醒語後,表現最好的模型降到 23%(Omar et al., 2025)。這是刻意設計的對抗式測試,不等於日常使用,但顯示 AI 不會自動質疑你給它的內容。
AI 對血壓這類數字,特別容易讀錯嗎?
在韓國一項 1 萬筆健檢個案的測試中,提示裡已經寫明各項判讀門檻,四個模型中表現較好的三個,血糖、膽固醇等多數生化項目的分類分數是 0.99 到 1.00,血壓是 0.88 到 0.91;第四個模型的血壓只有 0.61,生化項目也較低(You & Shin, 2026)。作者推測是血壓要同時看兩個數值、門檻又分好幾層。這是結構化資料、韓文提示的測試,不能直接推到所有報告。
用繁體中文問 AI,答案會比較可靠嗎?
本文能引用的證據很少,納入的繁體中文研究只有一項:2023 年 4 月的 GPT-3.5 回答 20 題兒童近視問題,10 位眼科醫師評估後,不到一半達到適當、可用、清楚的標準(Chang et al., 2024)。這是單一主題、舊版模型,不能推論到驗血報告。
民眾會不會太相信 AI?上傳報告的隱私有風險嗎?
在 AI 改寫出院衛教指示的實驗中,有研究看到這個傾向:越習慣依賴生成式 AI 的人,信任度越不隨內容正誤而變(Ahmed et al., 2026);隱私與資料安全也是部分研究記錄到的使用者顧慮(Alon & Levkovich, 2026)。但針對檢驗報告這個情境的研究,我們沒有查到。資料如何保存與使用,取決於各服務的資料政策。
資料來源
LLM 單獨作答:94.9% 提出至少一個相關病況、處置方向 56.3%;真人使用:不到 34.5%/44.2%;辨識病況顯著差於對照組(對照組勝算 1.76 倍,95% CI 1.45–2.13),處置方向無顯著差異;30 段對話中 16 段一開始只給部分資訊
Bean AM, et al. Nature Medicine. 2026;32(2):609–615(線上 2026-02-09). DOI: 10.1038/s41591-025-04074-y
100 筆抽樣:只下一句指令平均 0.69,四種提示疊加後 0.95(其中寫入判讀門檻一步 0.80→0.92);1 萬筆:前三個模型多數生化項目 0.99–1.00、血壓 0.88–0.91,LLaMA 3.1-70B 同批生化項目 0.66–0.98、血壓 0.61;兩個模型的血壓判讀隨年齡下降
You J, Shin H. npj Digital Medicine. 2026;9(1):565(線上 2026-07-22). DOI: 10.1038/s41746-026-02467-y
五個 LLM 解讀 120 份尿液報告:整體評分 4.57–4.78(滿分 5);儀器旗標解讀較差;最低幻覺率 7.5%(Claude-4.5);幻覺型態為誤解、定義錯誤、過度詮釋
Liu T, et al. Clinical Chemistry and Laboratory Medicine. 2026;64(8):1826–1837(線上 2026-04-20). DOI: 10.1515/cclm-2026-0435
300 個模擬案例各含一個捏造細節;預設設定下依模型與案例長短 50%–82%(最低 GPT-4o、最高 Distilled-DeepSeek-R1)、整體 66%;加提醒語後整體 44%,最佳模型 53%→23%(皆 p<0.001)
Omar M, et al. Communications Medicine. 2025;5(1):330(線上 2025-08-02). DOI: 10.1038/s43856-025-01021-3
888 則回答、222 題:有問題的回答 21.6%–43.2%,不安全 5%–13%;機器人之間有顯著差異
Draelos RL, et al. npj Digital Medicine. 2026;9(1):241(線上 2026-02-13). DOI: 10.1038/s41746-026-02428-5
ChatGPT 以繁體中文回答 20 題兒童近視問題,不到一半達到適當、可用、清楚的標準;治療效果與副作用題目不足
Chang LC, et al. Digital Health. 2024;10(線上 2024-09-02). DOI: 10.1177/20552076241277021
對生成式 AI 的依賴越高,越信任其輸出,信任度越不隨資訊正誤而變
Ahmed A, et al. Journal of Medical Internet Research. 2026(線上 2026-09-16). DOI: 10.2196/98326
27 項研究中 4 項把隱私或資料安全顧慮列為使用障礙
Alon L, Levkovich I. Journal of Medical Internet Research. 2026(線上 2026-09-02). DOI: 10.2196/93944